研究 · 发布于 2026年9月
作者:Marin Tintchev,GeoSynapse 与 China GEO EU 创始人
为什么 AI 的回答每次运行都不同——这对衡量可见度意味着什么
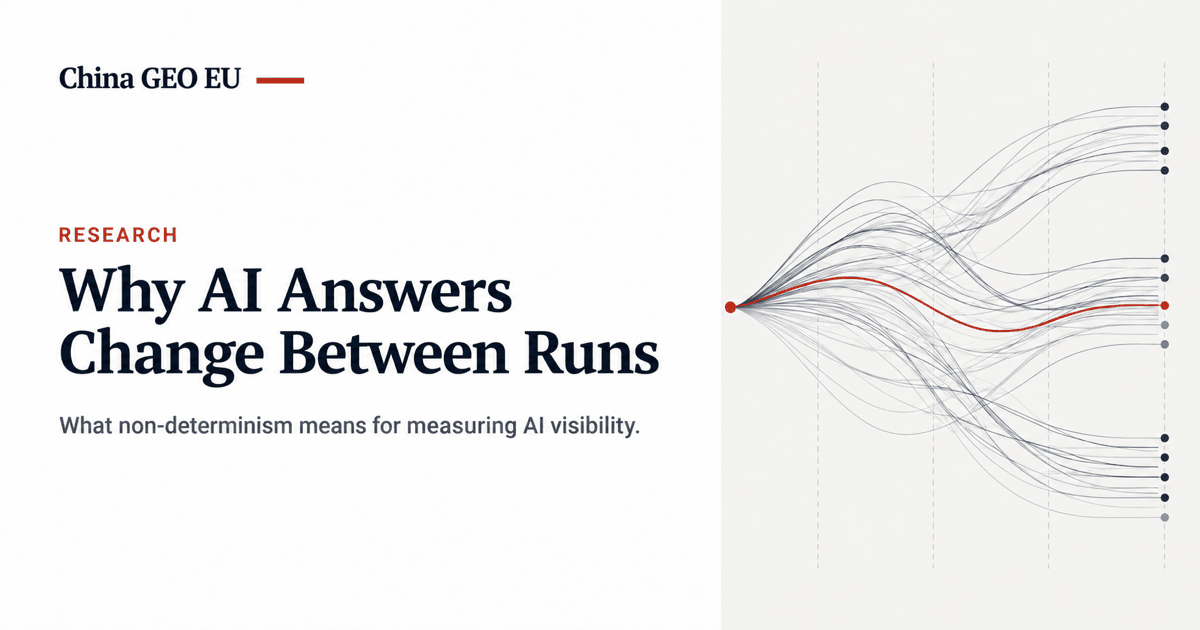
单次测试一个 AI 系统所能告诉您的信息非常有限。以下是背后的研究依据,以及可见度实际应当如何被衡量。
为什么 AI 的回答每次运行都不同?
关于 AI 搜索可见度的独立研究发现,即使问题本身和底层模型都没有变化,同一问题的重复运行结果也会有所不同[1]。这并不是在说某个平台不可靠——而是大规模生产环境中大语言模型服务方式的一种固有属性。
FACT
这是否是一个已被记录、经过验证的现象?
是的。对生产环境大语言模型推理的分析发现,服务基础设施中存在批次层面的非确定性——这是一种已被记录的输出差异来源,不同于且影响大于普通的浮点舍入差异。这意味着通过同一接口提交的完全相同的查询,即使系统的温度参数设为零,也可能返回有意义的不同结果[1]。
INFERENCE
这对衡量 AI 可见度意味着什么?
如果单次查询在不同运行中可能返回不同结果,那么"这个 AI 系统是否提到我的公司"的单次测试就不是可靠的衡量方式——它只是可能答案分布中的一个样本。仅基于每个平台、每个问题一次运行的可见度衡量,存在把噪声当作信号的风险,无论方向如何:假阴性(仅在这一次运行中未被提及)或假阳性(仅在这一次运行中被提及,并不代表典型行为)。
一套可信的 AI 可见度方法论应当如何应对这一点?
一套可信的 AI 可见度方法论,必须在得出关于公司是否、以及如何被呈现的结论之前,在多个平台上多次运行每个问题。这正是我们方法论页面所描述的多次运行协议的依据,也是我们自己的AI 可见度审计所采用的同一原则。
这也是我们对任何仅基于单次查询结果的 AI 可见度宣称——无论是我们自己的还是竞争对手的——都保持谨慎的原因。一次有利的提及并不能证明存在稳定的模式,无论方向如何。
参考文献
- Schulte, Bleeker & Kaufmann, "Don't Measure Once: Measuring Visibility in AI Search (GEO)," arXiv:2604.07585 (2026).
常见问题
这是否意味着 AI 可见度测试本质上不可靠?
不是——这意味着单次测试不可靠。按照我们《方法论》中所述,在多个平台上多次运行同一问题的方法,能够在单次运行存在波动的情况下,依然产生足够稳定、可据以行动的信号。
回答的波动性是否在所有 AI 平台上表现一致?
造成这一现象的底层原因(服务基础设施中的批次层面非确定性)是大语言模型大规模部署方式的普遍属性,并非某一家平台独有——但本文并未测量不同平台之间波动幅度是否存在实质差异;这需要专门针对各平台的实证测试,而我们尚未发布相关结果。
单次 AI 查询结果是否可以被当作可信的衡量依据?
不能单独作为依据。应将单次回答视为一个数据点,而非定论——就像不能仅凭一条顾客评价或一位分析师的引述下结论一样。
关于作者
Marin Tintchev 是 GeoSynapse 与 China GEO EU 的创始人。他在信息通信技术及国际商务领域拥有 30 余年经验,足迹遍布中国与欧洲,毕业于清华大学,精通普通话。